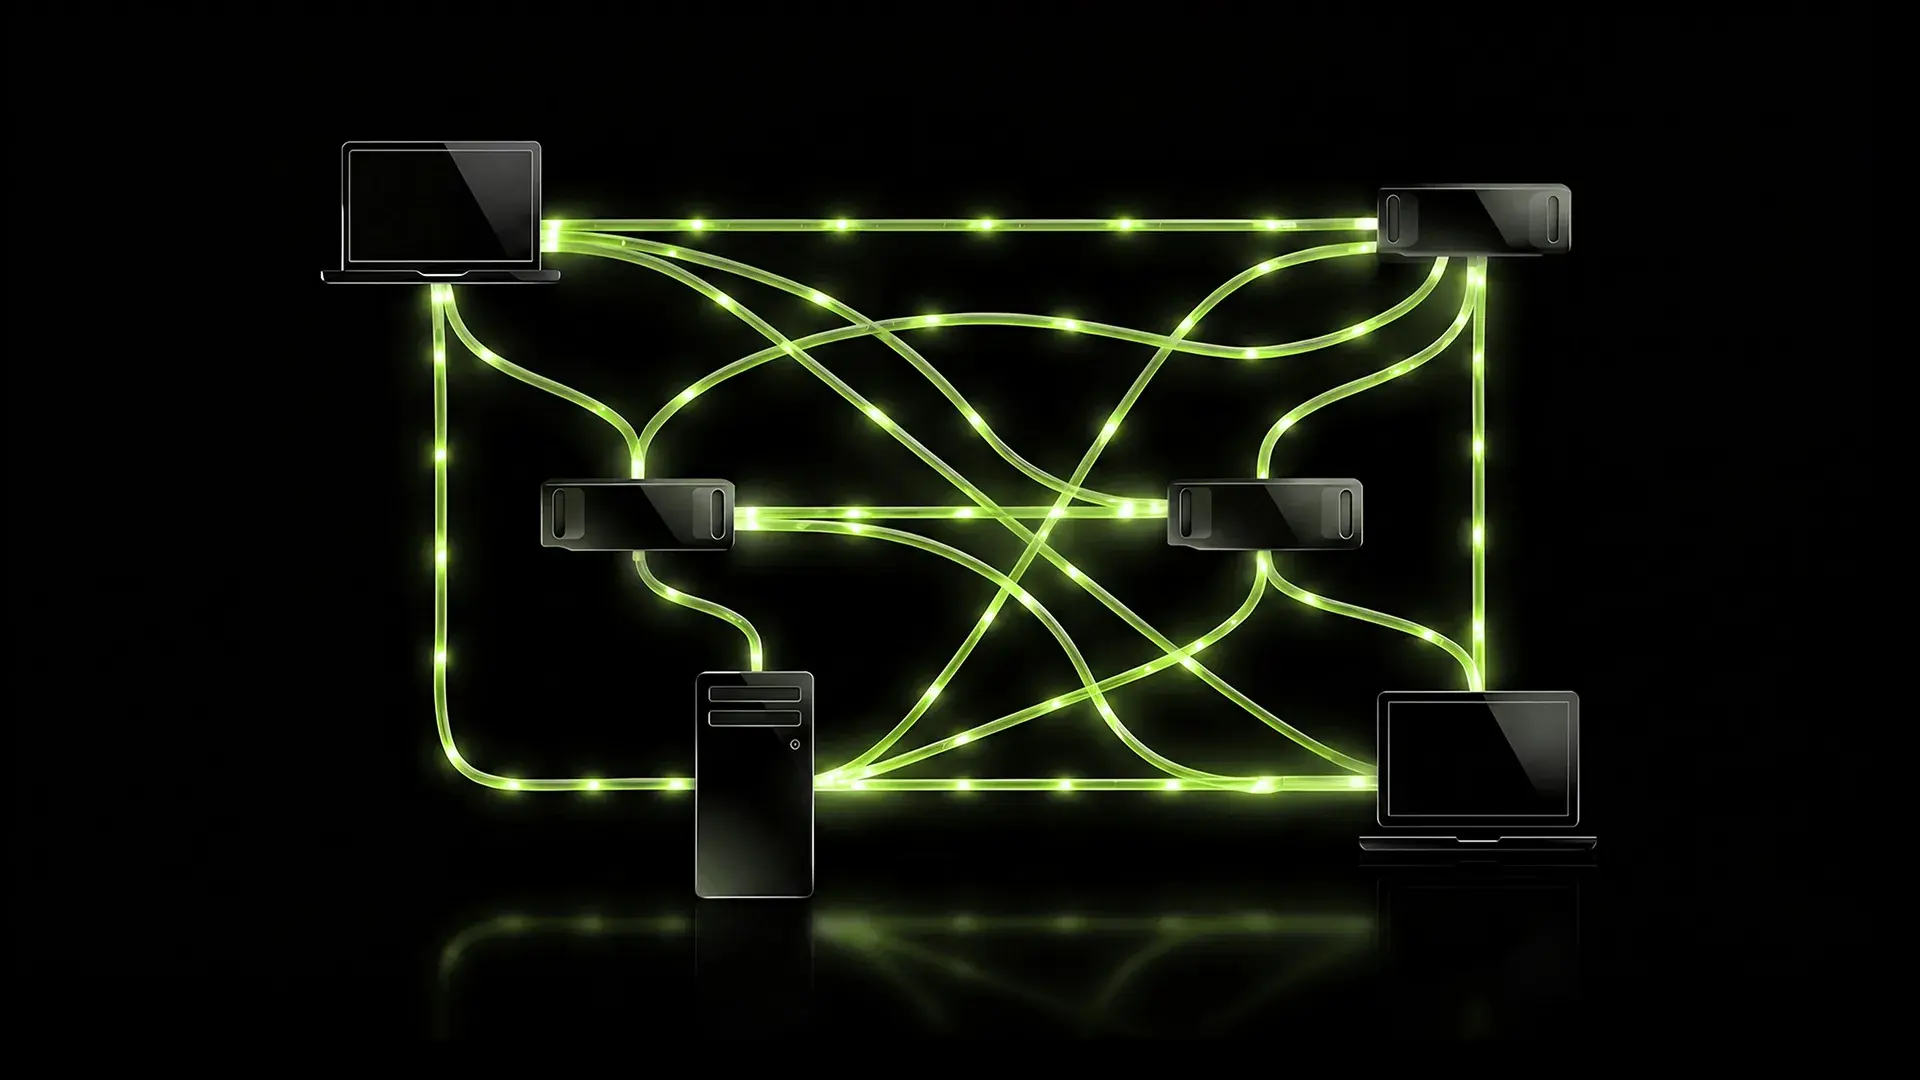
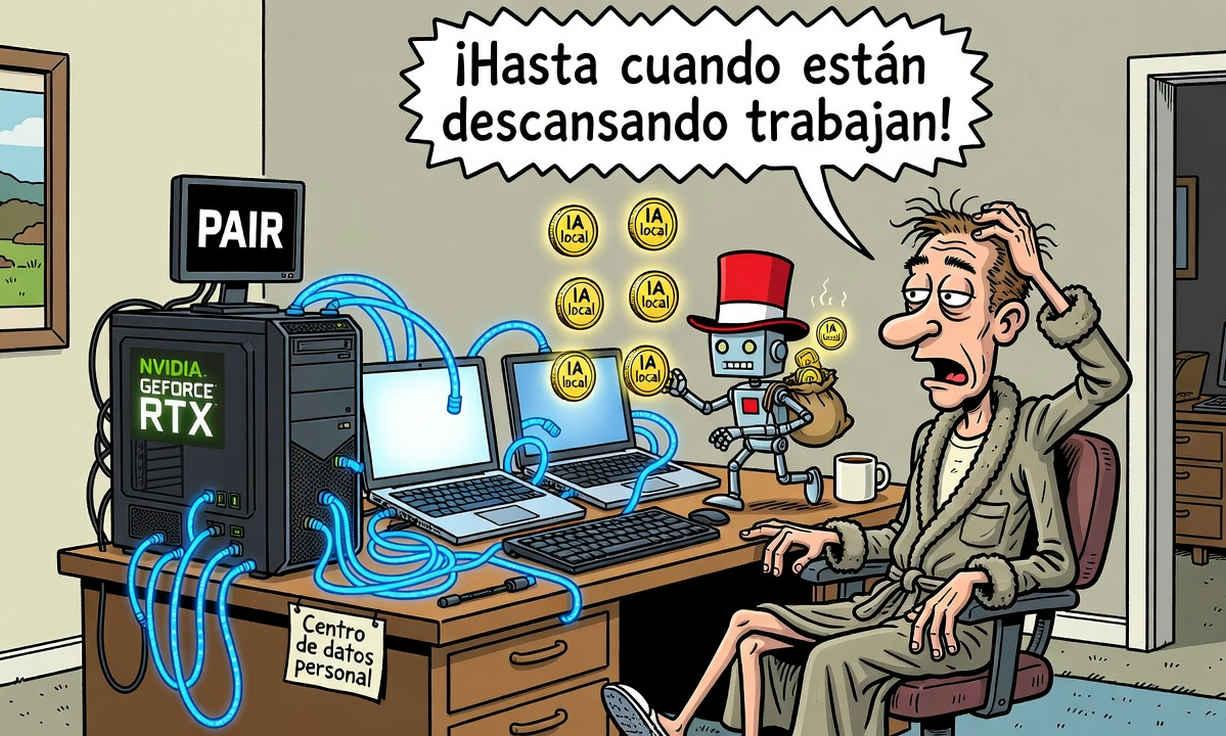
Tại IFA 2026, NVIDIA đã giới thiệu một giải pháp sẽ định nghĩa lại trí tuệ nhân tạo cục bộ. Được gọi là Bộ định tuyến AI cá nhân, hay viết tắt là PAIR, mục tiêu của nó là tận dụng các máy tính gia đình hiện có để chạy các tác vụ AI một cách cộng tác. Nó không phải là một bộ định tuyến vật lý hay một công cụ suy luận mới, mà là một công cụ hoạt động như một trung gian giữa các ứng dụng AI và các thiết bị khác nhau trên mạng cục bộ.
Ý tưởng rất đơn giản: nếu bạn có một máy tính chơi game, một máy trạm, hoặc thậm chí là một chiếc MacBook với chip hiện đại, rất có thể một phần đáng kể sức mạnh tính toán của nó đang không được sử dụng trong nhiều giờ mỗi ngày. PAIR phát hiện các thiết bị này, kết nối chúng một cách an toàn và phân phối các yêu cầu suy luận được tạo ra bởi các tác nhân AI giữa chúng, đảm bảo rằng khối lượng công việc không bị quá tải bởi một card đồ họa duy nhất.
NVIDIA PAIR chính xác là gì?
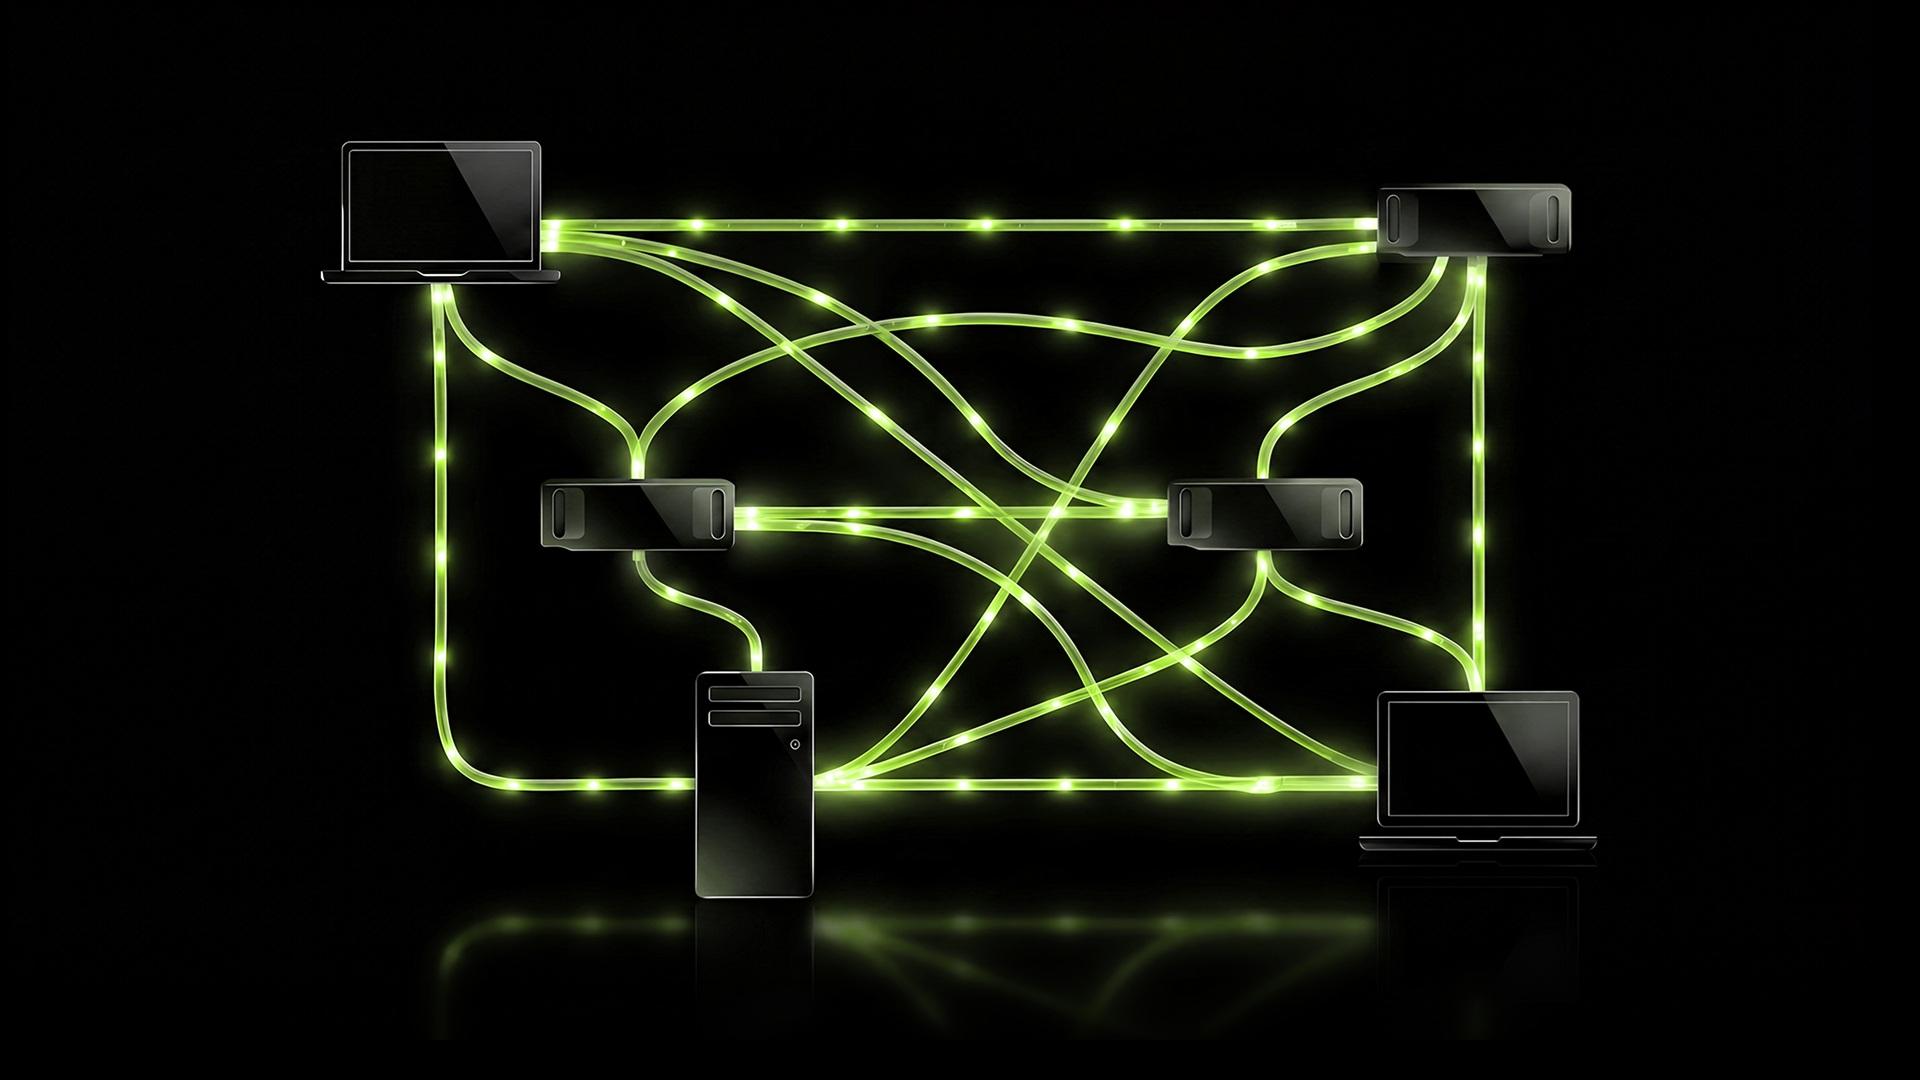
PAIR là một phần mềm mã nguồn mở miễn phí hoạt động như một máy chủ trung gian giữa các ứng dụng AI và các công cụ suy luận được cài đặt trên mỗi máy. Khi một tác nhân khởi chạy nhiều tác vụ con đồng thời, PAIR sẽ quyết định máy nào trên mạng có thể xử lý từng tác vụ, dựa trên việc máy đó có tải mô hình được yêu cầu hay không, tải GPU hiện tại và tình trạng sẵn sàng của máy. Đối với người dùng, trải nghiệm rất liền mạch: họ chỉ thấy một kết nối duy nhất, trong khi đó, lưu lượng truy cập được phân phối giữa các nút tham gia.
Một trong những tính năng chính của nó là không thay thế Ollama hay LM Studio , mà tận dụng chúng. Trên thực tế, PAIR kiểm soát các cổng mà các công cụ này sử dụng theo mặc định để nhận yêu cầu và chuyển tiếp chúng đến nút phù hợp nhất. Điều này có nghĩa là các ứng dụng hiện có có thể tiếp tục hoạt động mà không cần thay đổi, giảm đáng kể rào cản gia nhập cho những người đã thiết lập môi trường AI cục bộ của họ.
Cách thức phân công nhiệm vụ hoạt động
Việc phát hiện thiết bị được thực hiện bằng mDNS, cùng một giao thức mà máy in sử dụng để hiển thị trên mạng . Sau khi cài đặt, mỗi máy sẽ thông báo về trạng thái hoạt động của mình, và các máy khác sẽ tự động phát hiện ra nó. Bạn cũng có thể thêm một nút trực tiếp bằng địa chỉ IP của nó, nhưng quy trình thông thường là máy chính sẽ hiển thị mã PIN sáu chữ số mà thiết bị khác phải nhập để thiết lập ghép nối.
Sau khi kết nối, quá trình giao tiếp giữa các nút được mã hóa bằng mTLS, nghĩa là sử dụng chứng chỉ tương hỗ để đảm bảo lưu lượng truy cập không rời khỏi mạng riêng . Điều này rất quan trọng đối với những người xử lý thông tin nhạy cảm, vì hướng dẫn và dữ liệu của tác nhân vẫn nằm trong mạng nội bộ mà không đi qua bất kỳ máy chủ bên ngoài nào. Tuy nhiên, các nhà phát triển dự án cảnh báo rằng cần xem xét lại bảo mật mạng LAN trước khi sử dụng nó trên các mạng dùng chung hoặc không đáng tin cậy, vì nó mở các điểm cuối HTTP cục bộ và cho phép phát hiện trên mạng LAN.
Biểu diễn và trình diễn
Câu hỏi quan trọng nhất là liệu nó có thực sự cải thiện hiệu năng hay không. NVIDIA đã chia sẻ một bản demo không chính thức với tác nhân Hermes Desktop và Ollama chạy trên mô hình Qwen 3.6 35B A3B. Một tác vụ gồm năm tác nhân con, trung bình mất 18 phút trên một máy tính xách tay RTX Spark duy nhất, đã được hoàn thành trong 8 phút 48 giây khi sử dụng cụm ba máy : máy tính xách tay, một DGX Spark và một RTX 5090. Sự cải thiện hơn gấp đôi này được giải thích bởi thực tế là các tác vụ con có thể được thực hiện song song trên nhiều GPU, thay vì xếp hàng trên một GPU duy nhất.
Công ty nhấn mạnh rằng đây không phải là một tiêu chuẩn chung cũng không phải là lời hứa về khả năng mở rộng tuyến tính . Kết quả phụ thuộc rất nhiều vào loại khối lượng công việc, mô hình được sử dụng, cấu hình mạng và các nút có sẵn. Các tác vụ có tính tuần tự cao, hoặc những tác vụ chỉ có một máy có mô hình cần thiết, sẽ thấy ít lợi ích. Hơn nữa, PAIR không gộp bộ nhớ của các card đồ họa khác nhau, vì vậy nó không phải là giải pháp để tải một mô hình không vừa với một GPU duy nhất.
Khả năng tương thích và yêu cầu
Phiên bản beta của PAIR hiện có sẵn cho Windows 11, Linux và macOS , hỗ trợ kiến trúc x64 và arm64 (mặc dù Windows trên ARM vẫn đang trong giai đoạn thử nghiệm). Yêu cầu phần cứng bao gồm GPU GeForce RTX 20 Series trở lên, RTX PRO dựa trên kiến trúc Turing trở lên, DGX Spark hoặc chip Apple M4 trở lên. Cần tối thiểu 8 GB RAM và 20 GB dung lượng ổ cứng, và không cần kết nối internet để hoạt động, chỉ cần kết nối để tải xuống các mẫu.
Một chi tiết thú vị là PAIR không chỉ giới hạn ở các sản phẩm của NVIDIA ; bất kỳ máy tính nào có thể chạy Ollama hoặc LM Studio đều có thể tham gia, bao gồm cả các hệ thống sử dụng Apple Silicon. Trên thực tế, nó đã được thử nghiệm thành công trên các mạng lưới lên đến 18 GPU. Tính linh hoạt cho phép các nút tham gia và rời đi tùy ý—ví dụ, nếu máy tính xách tay chuyển sang chế độ ngủ hoặc máy tính để bàn bắt đầu chơi game—là một trong những tính năng nổi bật khác của nó, vì bộ lập lịch điều chỉnh việc phân phối trong thời gian thực.
RTX Spark và các tính năng mới khác
Sự kiện PAIR diễn ra vào thời điểm NVIDIA cũng đang hoàn tất việc ra mắt những chiếc PC đầu tiên với RTX Spark, dự kiến vào tháng 10. Những chiếc máy này kết hợp GPU Blackwell với CPU Grace 20 nhân và bộ nhớ hợp nhất lên đến 128 GB, được thiết kế để chạy các tác nhân AI cục bộ. Tại IFA, Lenovo (Yoga Pro 9n và Yoga 9n) và Acer (một concept máy tính để bàn nhỏ gọn) đã trưng bày các sản phẩm của họ, và Dell, HP, ASUS, MSI và Microsoft đều được kỳ vọng sẽ công bố các mẫu máy của mình.
Cùng với PAIR, NVIDIA cũng đã công bố những cải tiến đơn giản hóa cho các dự án agent khác. Perplexity Portable Computer sẽ hỗ trợ GPU RTX với tối thiểu 24 GB VRAM trên cả Windows và Linux, cho phép người dùng chạy toàn bộ quy trình làm việc mà không cần tốn tiền và cần có sự cho phép trước để gửi dữ liệu lên đám mây. Hermes Agent sẽ tích hợp thiết lập chỉ bằng một cú nhấp chuột, tự động phát hiện GPU, và OpenClaw cũng sẽ có tùy chọn tương tự trên Windows.
Về hiệu năng, các tối ưu hóa trong llama.cpp cho phép tăng thông lượng lên đến 1,9 lần trên GeForce RTX 5090 , trong khi vLLM cải thiện thông lượng lên 1,2 lần trên Blackwell RTX PRO 6000 và lên đến 1,4 lần trên cụm hai card DGX Spark. Những cải tiến này đã có sẵn thông qua LM Studio, Ollama và chính các engine.
Tất cả những điều này chỉ ra một xu hướng rõ ràng: chuyển phần lớn công việc AI ra khỏi đám mây và tận dụng phần cứng mà chúng ta đã có sẵn ở nhà. PAIR là một mảnh ghép khác trong bức tranh đó, và mặc dù vẫn đang trong giai đoạn thử nghiệm beta, nhưng nếu bạn có nhiều hơn một máy tính mạnh thì rất đáng để thử. Phiên bản cuối cùng vẫn chưa có ngày phát hành, nhưng cộng đồng đã có thể tải xuống và đóng góp cải tiến thông qua GitHub.
Index